사이트 색인 누락, 설정 실수부터 의심해야 하는 이유
어제까지 검색되던 글이 갑자기 안 보이면 정말 당황스럽죠. 이런 사이트 색인 누락은 글 내용보다 사이트 주인이 직접 넣어 둔 설정 한 줄 때문에 생기기도 해요. noindex 태그나 robots.txt 규칙은 몇 분이면 확인할 수 있어서, 글을 고치기 전에 먼저 보는 편이 시간을 아끼는 길이거든요.
📌 핵심 요약
색인 누락은 설정 실수부터 찾고, 고친 뒤 서치 콘솔에서 다시 요청하면 됩니다.
대표적인 원인은 noindex, robots.txt, 캐노니컬 세 곳이에요. 다만 고친다고 바로 돌아오지는 않으니 순서를 지켜 진행하세요.
📑 목차
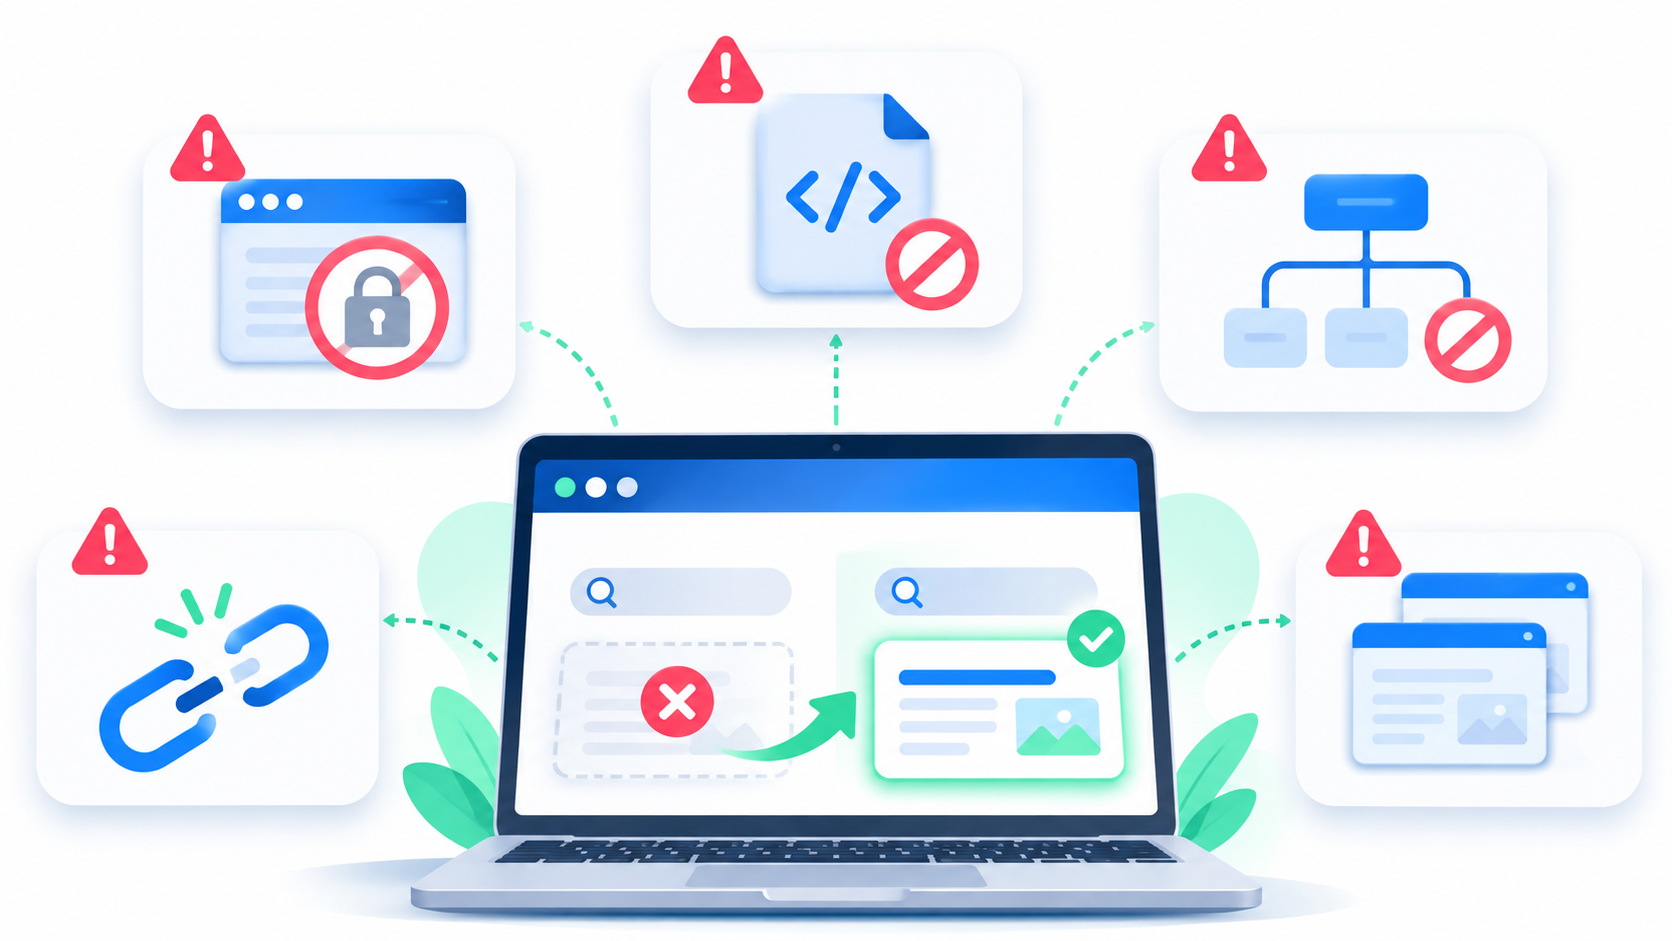
색인 누락 부르는 설정 실수 5가지 한눈에 보기
가운데 칸은 서치 콘솔 '페이지 색인 생성' 보고서에 나오는 상태 이름이에요. 내 사이트에 뜬 이름을 이 표와 맞춰 보면, 다섯 가지 중 어느 실수인지 바로 좁혀지죠.
noindex 태그를 지우지 않고 공개한 실수
자주 보이는 경우는 개발 중에 넣어 둔 noindex를 그대로 둔 채 사이트를 공개하는 거예요. 워드프레스라면 설정의 읽기 메뉴에 있는 '검색 엔진이 이 사이트를 색인하지 않도록' 체크가, 다른 사이트라면 SEO 플러그인의 페이지별 옵션이 이 태그를 넣죠. 그래서 페이지 소스에서 robots 메타 태그 값에 noindex가 들어 있는지부터 보세요. 원인을 처음부터 넓게 짚고 싶다면 이 주제를 처음부터 정리한 글(우리 블로그의 누락 자가 진단 글)을 같이 보면 도움이 돼요.
⚠️ 주의사항
noindex는 HTML이 아니라 서버 응답 헤더(X-Robots-Tag)에 붙기도 해요. 소스에 안 보인다고 끝내지 말고 URL 검사 결과의 '색인 생성 허용 여부' 항목까지 보세요.
robots.txt로 막아 놓고 noindex까지 건 실수
robots.txt의 Disallow는 크롤링을 막는 규칙이지, 검색 결과에서 빼는 규칙이 아니에요. 반대로 noindex는 구글이 페이지를 직접 읽어야 효력이 생기죠. 그래서 둘을 한꺼번에 걸면 구글이 noindex를 보지 못하고, 막힌 주소가 설명 없이 검색에 남는 일도 생겨요. 복구할 때는 robots.txt에서 해당 경로의 Disallow 줄을 먼저 지우세요. 이때 'Disallow: /' 한 줄만 있어도 사이트 전체가 막힌다는 점을 기억해 두면 좋습니다.
💡 꼭 알아두세요
서치 콘솔 설정 메뉴의 robots.txt 보고서에서 구글이 마지막으로 가져간 파일 내용을 볼 수 있어요. 고친 파일이 구글 쪽에 반영됐는지 여기서 보면 됩니다.
캐노니컬과 리디렉션이 엉뚱한 주소를 가리키는 실수
모든 글의 캐노니컬이 홈 주소를 가리키도록 만들어진 테마가 있어요. 이러면 구글은 각 글을 홈의 사본으로 보고 글 주소를 색인에서 빼죠. 주소를 https나 www 형태로 옮긴 뒤 리디렉션을 빠뜨린 경우도 결과가 비슷해요. 예를 들어 http://example.com/post 로 들어온 방문이 https://example.com/post 로 넘어가지 않고 오류를 내면, 구글은 새 주소를 옛 주소와 같은 페이지로 이어 주지 못합니다.
📋 체크리스트
☑ 옛 주소가 한 번에 새 주소로 넘어간다
☑ 사이트맵에는 최종 주소만 들어 있다
고친 뒤 색인 누락 복구 요청은 이 순서로
실시간 URL 테스트
고친 주소를 서치 콘솔 상단 검사창에 넣고 '실시간 URL 테스트'를 눌러요. 수정이 구글 기준으로도 반영됐는지 여기서 갈립니다.
색인 생성 요청
테스트를 통과하면 '색인 생성 요청'을 눌러요. 같은 주소를 여러 번 요청해도 빨라지지 않는다고 구글 문서에 적혀 있어요.
사이트맵 제출과 수정사항 확인
페이지가 여러 개라면 사이트맵을 다시 제출하고, 페이지 색인 생성 보고서에서 '수정사항 확인'을 눌러요.
재크롤링은 며칠에서 몇 주까지 걸릴 수 있다고 구글 공식 문서에 나와 있어요. 그 사이 설정을 또 바꾸면 무엇이 효과를 냈는지 알 수 없게 되니, 기다리는 편이 낫죠.
오늘 바로 해 볼 한 가지
오늘 할 일은 하나면 충분해요. 검색에서 빠진 페이지 하나를 골라 서치 콘솔 URL 검사에 넣고, 결과에 뜬 상태 이름을 위 표와 맞춰 보세요. 원인이 noindex인지 robots.txt인지만 가려져도 고칠 곳이 정해지거든요. 반대로 상태가 '크롤링됨 - 현재 색인이 생성되지 않음'처럼 설정과 관계없는 이름이라면, 그때는 설정이 아니라 페이지 내용을 손볼 차례입니다. 어느 쪽인지 아는 것만으로 헛수고가 크게 줄어요.
자주 묻는 질문
Q. robots.txt에서 막은 페이지가 왜 검색 결과에 남아 있나요?
Q. 색인 생성 요청을 여러 번 누르면 더 빨리 복구되나요?
Q. noindex를 지웠는데도 계속 제외됨으로 나와요.
Q. 사이트 전체가 검색에서 사라졌다면 무엇부터 보나요?
참고자료
- Google 검색 센터 - noindex로 검색 색인 생성 차단 — meta 태그와 X-Robots-Tag 헤더로 noindex를 적용하는 방법과 robots.txt와 함께 쓸 때의 주의점
- Google 검색 센터 - robots.txt 소개 — robots.txt가 크롤링을 제어하는 범위와 색인 제외 용도로 쓰면 안 되는 이유
- Search Console 고객센터 - 페이지 색인 생성 보고서 — 보고서에 나오는 상태 이름별 의미와 수정사항 확인 절차
- Google 검색 센터 - Google에 URL 재크롤링 요청 — URL 검사 도구와 사이트맵으로 재크롤링을 요청하는 방법과 소요 시간 안내